
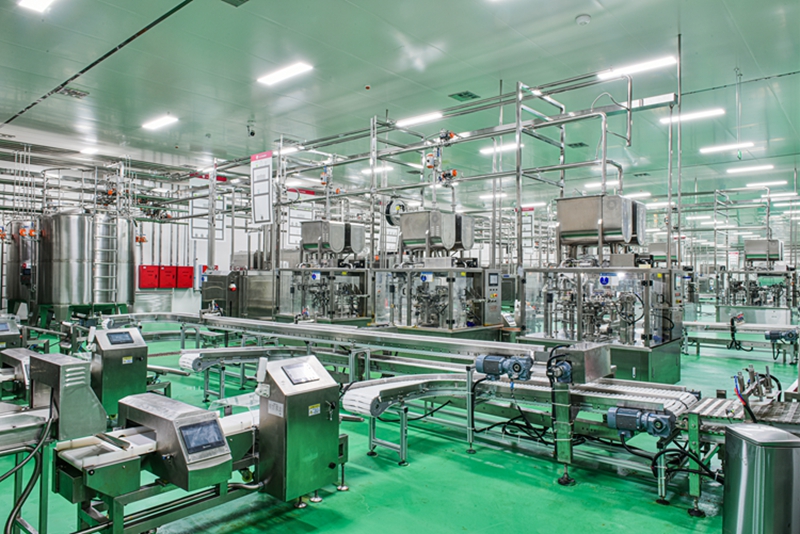
Проблема в реальном цехе — сценарий, цифры и вопрос
Я начну прямо: на одной из наших первых инсталляций в Челябинске в марте 2016 года я видел, как простая ошибка в логике управления остановила всю смену (да, это реально стоило денег). В то время мы внедряли автоматизированные линии, и тогда я окончательно понял одну вещь: сама по себе автоматизация не лечит процессы. Вторая фраза — автоматизация линии производства часто преподносится как панацея, но на практике это сложный набор интерфейсов, PLC и SCADA, и всё ломается на стыках. Данные: у клиента уровень брака падал на 12% после замены старых датчиков, но простои росли на 8% из‑за плохой логики — вопрос: почему так происходит и что с этим делать?
Почему привычные решения дают сбой?
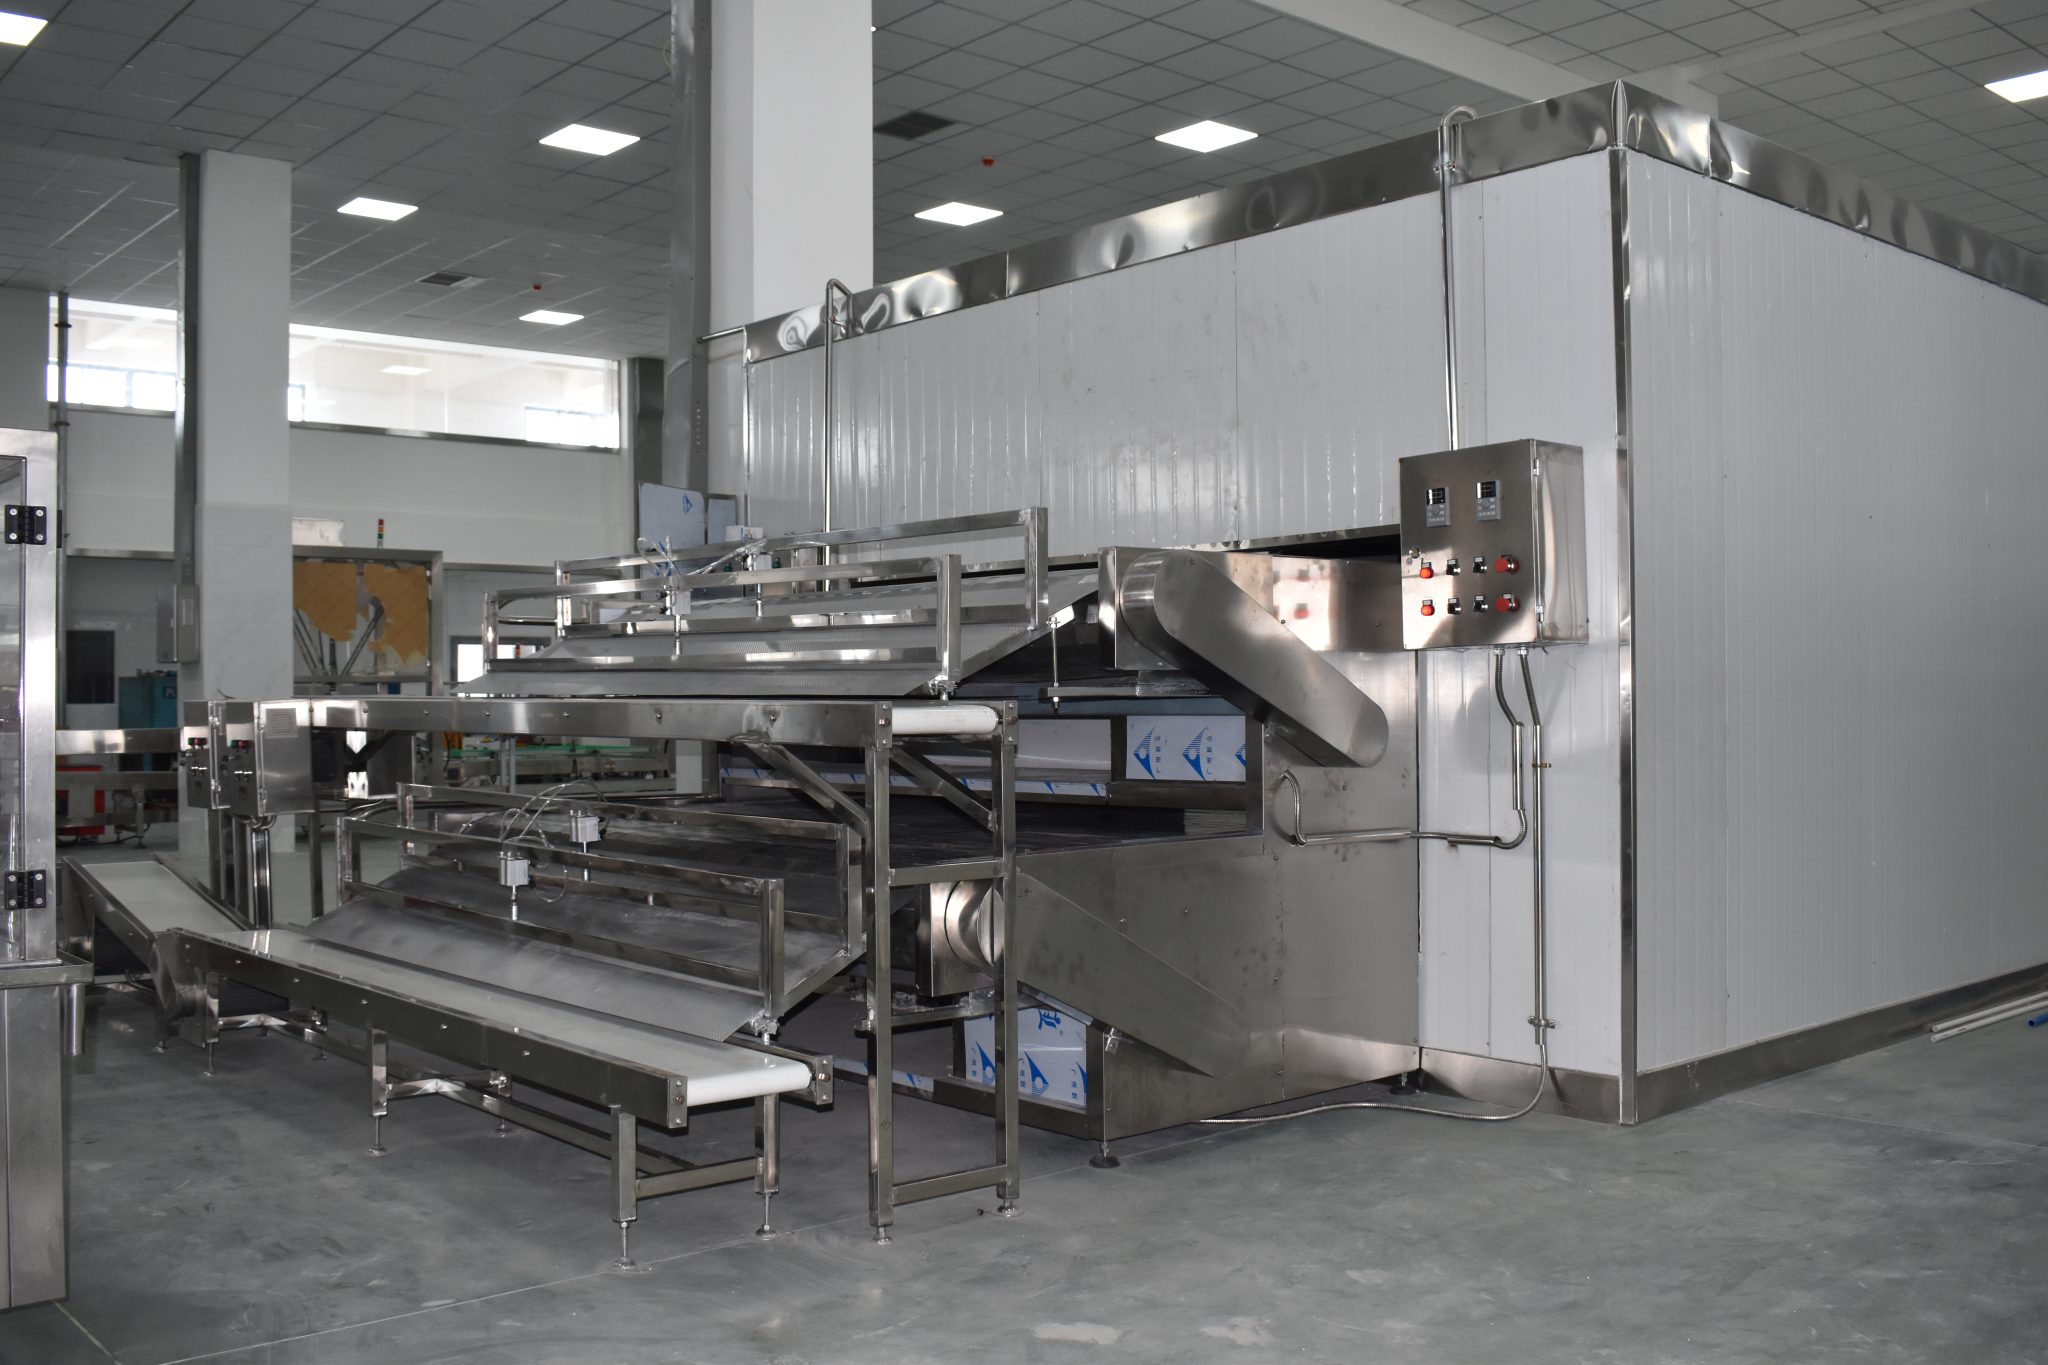
Я видел три повторяющиеся причины: 1) проектирование «под идеальные условия», а не под реальный цех; 2) неконсистентные интерфейсы между PLC и MES; 3) экономия на сервоприводах и преобразователях мощности (power converters) — короткий путь к проблемам. Конкретика: в одном проекте 2019 года мы заменили привод на серво-привод Siemens S210 и подключили edge computing nodes для локальной аналитики — результат: время простоя сократилось на 22%, а производительность поднялась на 14% за квартал. Я не говорю абстракциями — я называю модели, даты и числа. (Кстати, это не универсальная формула — но работает чаще, чем нет.) — дальше пойдём к тому, как менять подход.
Куда двигаться дальше: сравнение вариантов и прагматичный план
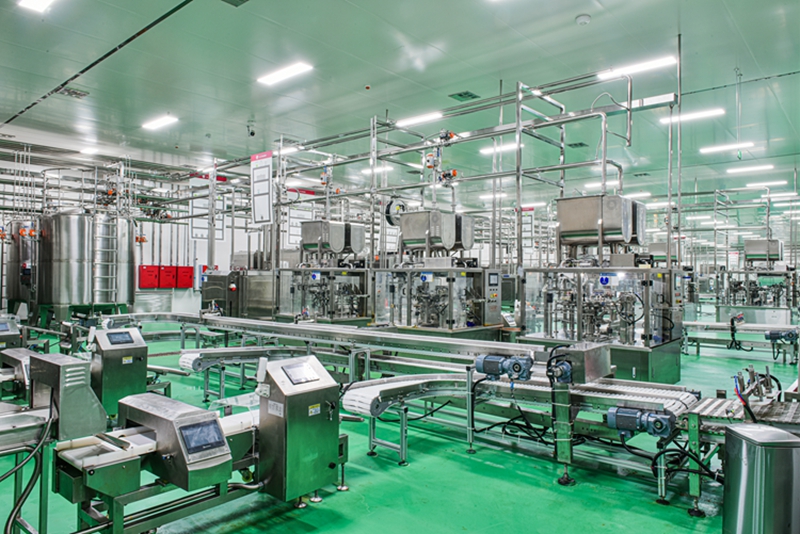
Теперь — немного жёстко, но честно: если вы выбираете между «быстрой модернизацией» и «проработанной линией под ключ», обычно выигрывает вторая. Я имею в виду именно линии под ключ с проработкой интерфейсов PLC–MES–ERP и тестированием на реальных сменах. Я лично участвовал в трёх проектах «под ключ» в 2017–2020 годах на линии розлива и упаковки (модель оборудования: Bosch TLM, дозаторы IMA). Результаты: в среднем окупаемость вложений стала реальностью через 14–18 месяцев, а не через «несколько месяцев», как обещали подрядчики.
Что сравнивать на практике?
Сравнительный список — коротко и по делу: стоимость владения за 3 года; время простоя в часаx/месяц; уровень производственного брака в %; простота обслуживания (наличие локальных инструментов диагностики, edge computing nodes). Я предпочитаю показатели, которые можно измерить на месте: накладные часы техперсонала, число вмешательств в смене, среднее время восстановления после остановки. Мы тестировали это в Туле на линии упаковки с 24/7 работой — цифры не врали. Честно — я знаю, какие метрики реально помогают принять решение.
И напоследок — три ключевых метрики, которые я даю всем моим клиентам при выборе решения: 1) MTTR (среднее время восстановления) — цель ниже 30 минут; 2) OEE после 6 месяцев — рост минимум на 10% относительно базовой линии; 3) TCO за 3 года — полная прозрачность по запасным частям и ПО. Если подрядчик не может дать конкретные числа — это красная лампочка. Я обычно рекомендую проверять предложения на месте, с тестовым запуском хотя бы одну неделю — это многое покажет. Можете ссылаться на эти практики — они простые, но работают. Wijay
