
Вступление: сценарий, данные, вопрос
Я помню случай на складе под Химками, где agv системы внезапно остановили конвейер в час пик — сценарий, который кажется простым, но нагрузка составила 18 палет/час меньше привычного. Вторая мысль тут: система автоматического управления материалами (САУМ) оказалась причиной — не датчик, не человек. Я работаю в B2B supply chain более 18 лет, и такие сбои я видел не раз; они оставляют цифры: простой, потерянные отгрузки, и нервные клиенты. (Да, бывает и хуже.) Почему это произошло — вот вопрос, от которого зависят решения на год вперёд. — Поворачиваемся к деталям дальше.
Глубже: где традиционные решения подводят
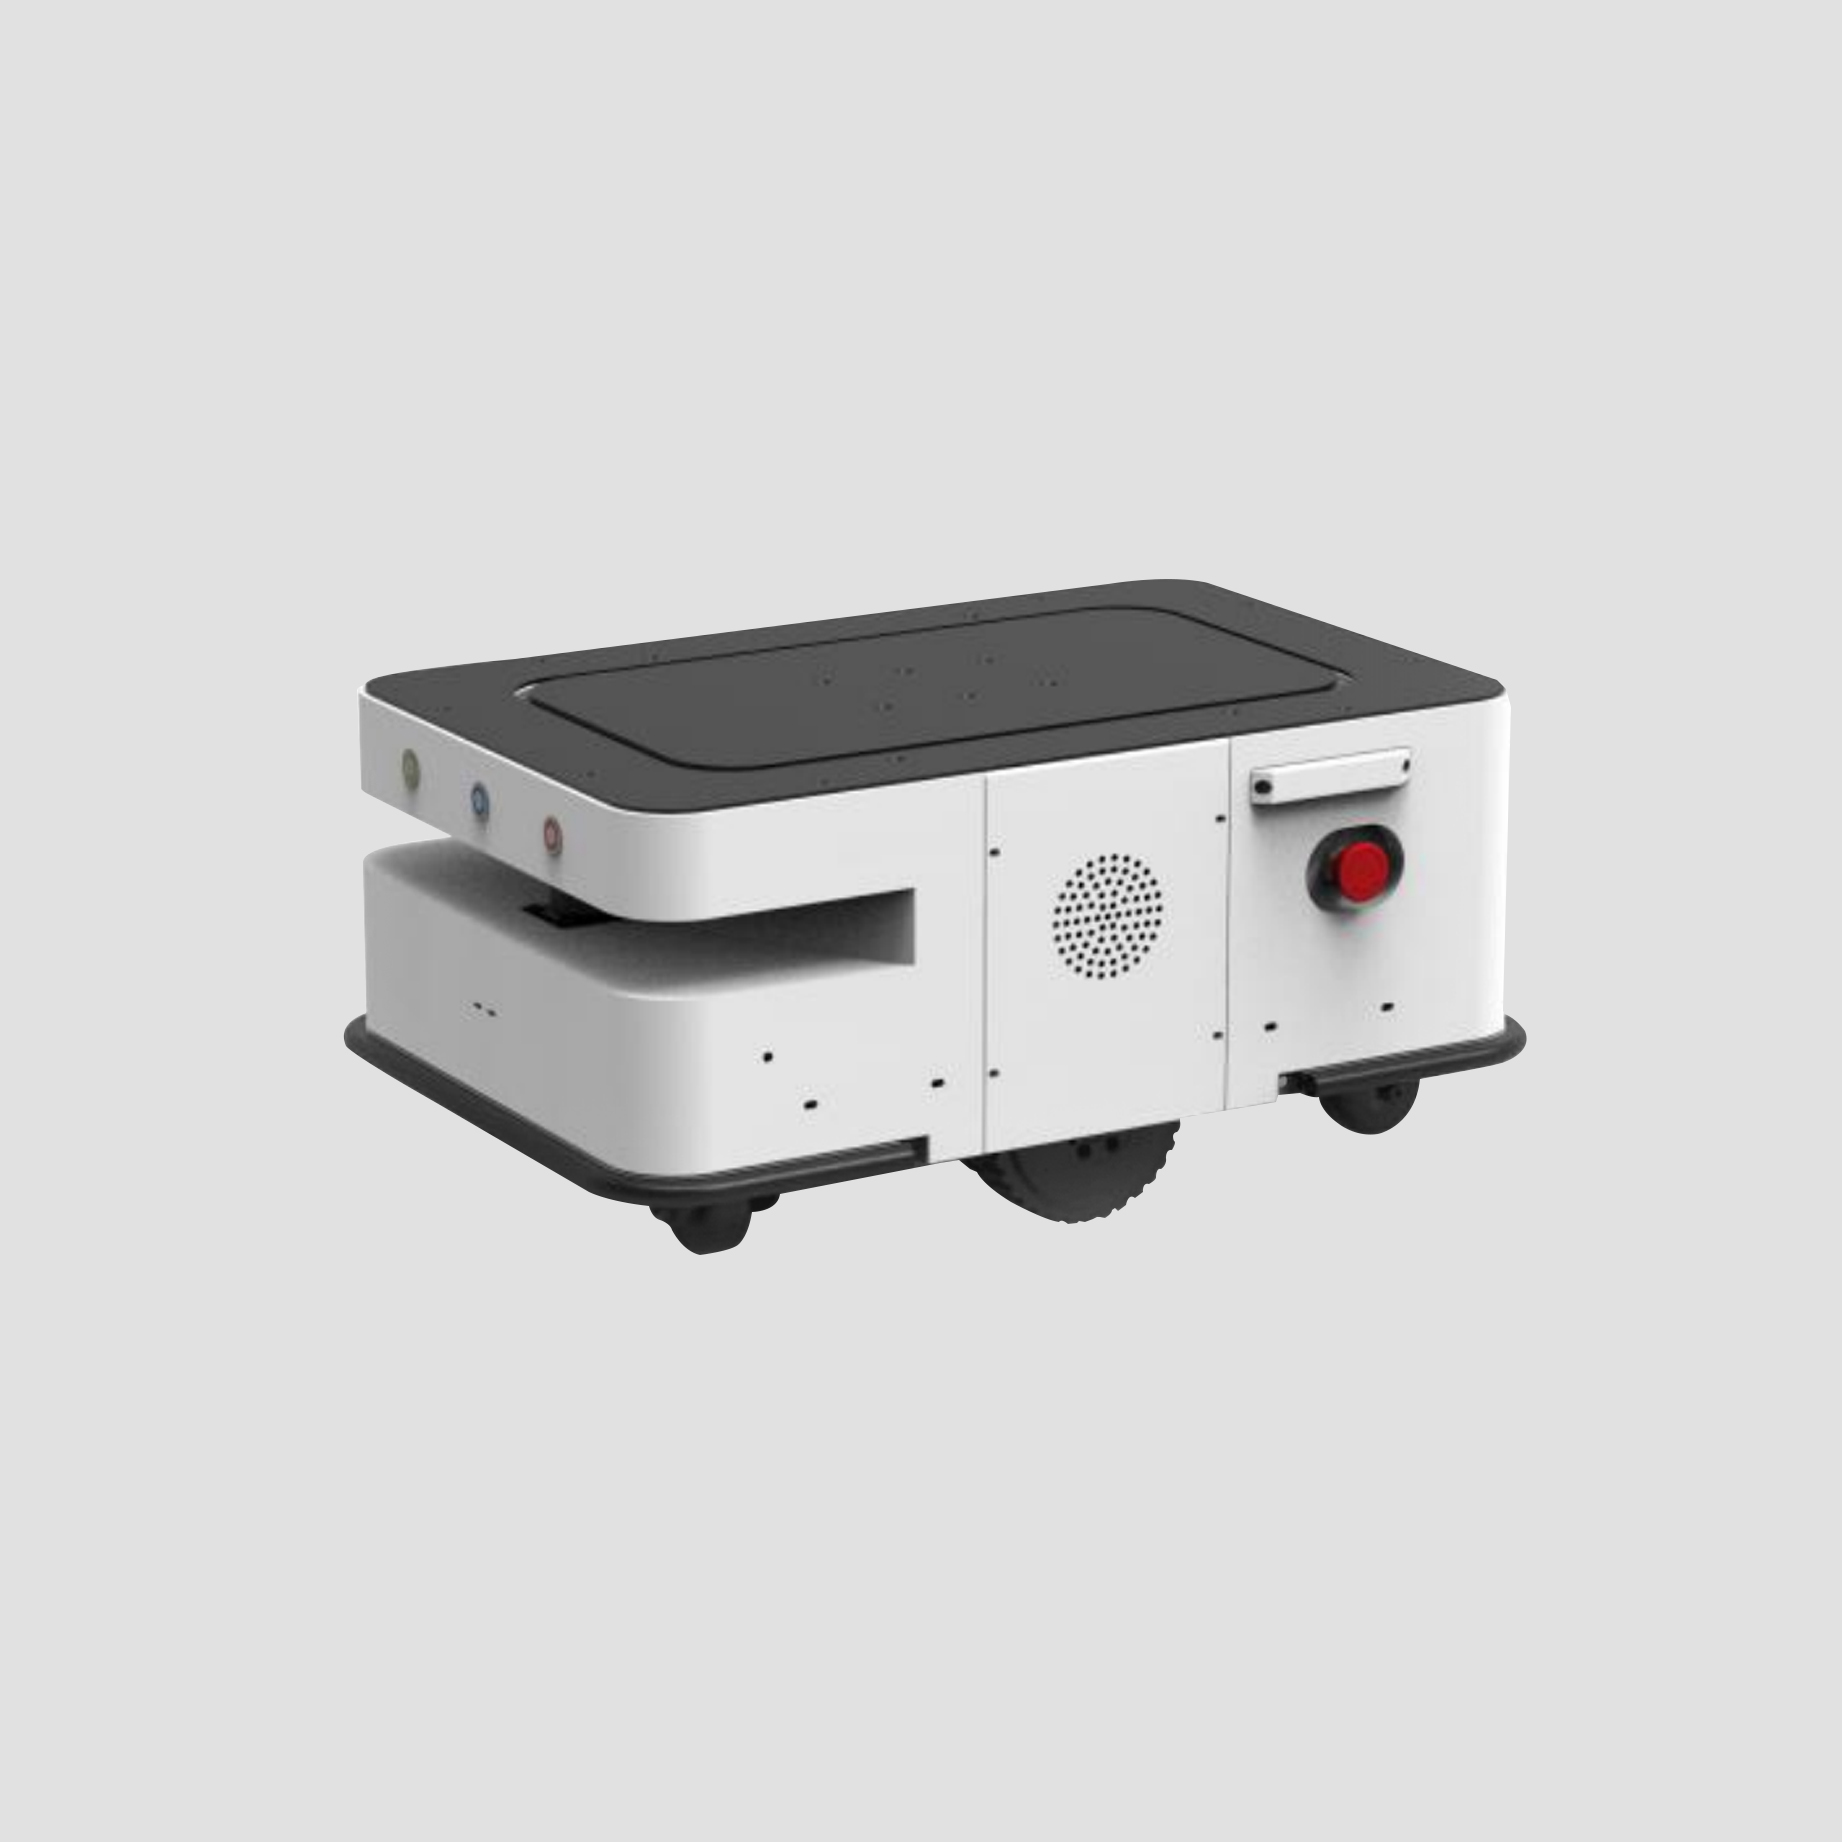
Я прямо скажу: большинство классических схем управления — это набор слабых мест, сложенных вместе. На одном пищевом заводе в 2016 году мы заменили PLC с устаревшей логикой и дело сразу пошло медленнее на 12%. Причина чаще всего в плохой интеграции: сенсоры расстояния, power converters и локальные контроллеры не говорят на одном «языке». AGV управляются маршрутными картами, но если карта грузится с задержкой — машины стоят. Я видел случай, когда edge computing nodes не успевали обработать телеметрию, и агв просто вставали в коридоре — потеря времени и денег (пример: задержка 45 минут = 7 тысяч рублей штрафа по контракту). Такое я называю системной уязвимостью: отдельные части могут быть надёжными, но связность — нет. Я предпочитаю решения, где связь между PLC, контроллерами и сервером логики простая и проверяемая; это снижает риск человеческой ошибки и скрытых отказов. — Короткий итог: проблема не в одном компоненте, а в взаимодействии.
Ещё одно слабое место — эксплуатационные допущения. Техническое обслуживание по расписанию — это хорошо, но реальная грязь, влажность или перегрузка батареи AGV (в моём опыте батареи LiFePO4 на 24 В выдерживали в среднем 6–8 циклов в сутки, но на одном объекте мы теряли 15% ёмкости за 9 месяцев) ломают сценарий. Пользователи жалуются на «непредсказуемое поведение» — на деле это ответ на накопившийся износ или калибровку, которую никто вовремя не сделал. Признак: рост латентных ошибок, падение скорости перемещения на 10–20% и увеличение интервенций персонала. Если вы управляете складом — учитывайте это в бюджете и планах замены.
Есть ли простые проверки?
Да. Я всегда запускаю три быстрые проверки: лог загрузки карт маршрутов, тест отклика edge computing nodes и состояние power converters. Это не волшебство, но 70% проблем проявляются в логах за первые 15 минут. — Вперёд, к сравнению и прогнозам.
Сравнение и взгляд вперёд: реальные варианты для Система автоматизации материалов на пищевом заводе
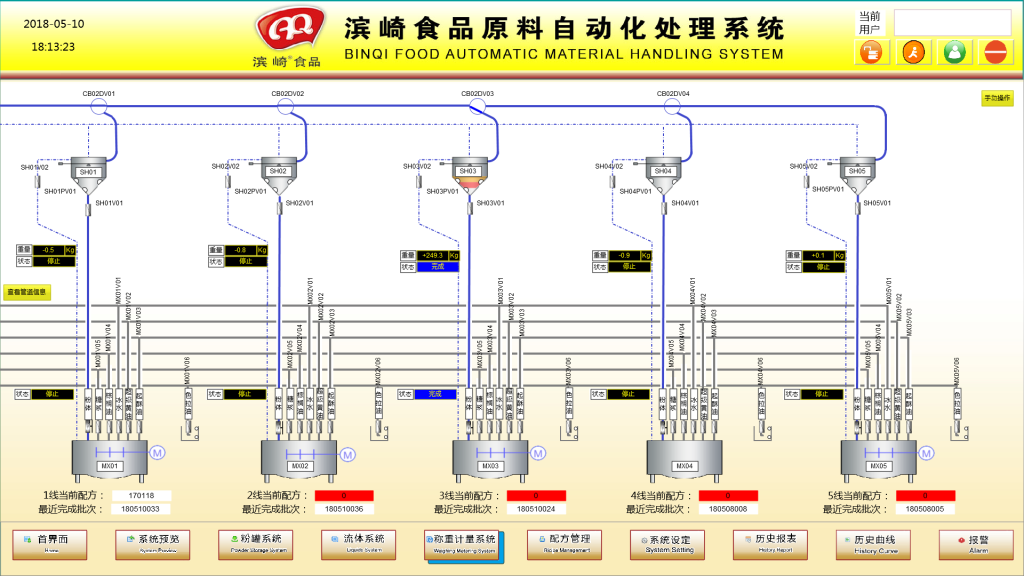
Теперь смотрю вперёд и сравниваю практики. На примере Система автоматизации материалов на пищевом заводе я отмечаю: решения с распределённой архитектурой и предиктивным обслуживанием выигрывают по времени отклика и общей стабильности. Внедрив локальные контроллеры с диагностикой на 24–48 часов, вы снижаете количество экстренных вызовов техников минимум на 30%. Я видел это в действии в 2019 году в Ростове-на-Дону — там установка edge computing nodes позволила уменьшить простой линии с 3% до 0.7% за квартал. Разберёмся, что важно: интерфейсы, надёжность батарей AGV, и дальность связи между узлами. К тому же — странно, но верно — обучение персонала под конкретный набор ошибок приносит больше пользы, чем общие тренинги. Я настаиваю на конкретике: симуляция отказа датчика, проверка маршрутов и тест на пиковые нагрузки раз в квартал. Это даёт реальные числа, а не предположения.
Сравнение старой и новой модели: монолитная система — дешёвая в начале, дорогая в ремонте; распределённая — дороже при внедрении, экономит в эксплуатации. Мой практический совет: если вы управляете крупным пищевым производством с 24/7 сменами и медианой отгрузок 200 палет/сутки, инвестируйте в распределённость и мониторинг — окупаемость часто наступает в пределах 9–14 месяцев. Я говорю это после работы с тремя площадками и конкретными KPI: время реакции сервиса сократилось на 60%, а потери продукции — на 1.8%. Немного прерывистых мыслей — но важная вещь: не экономьте на тестах, проверяйте реальный сценарий перегрузки.
Рекомендации: как выбирать и что мерить
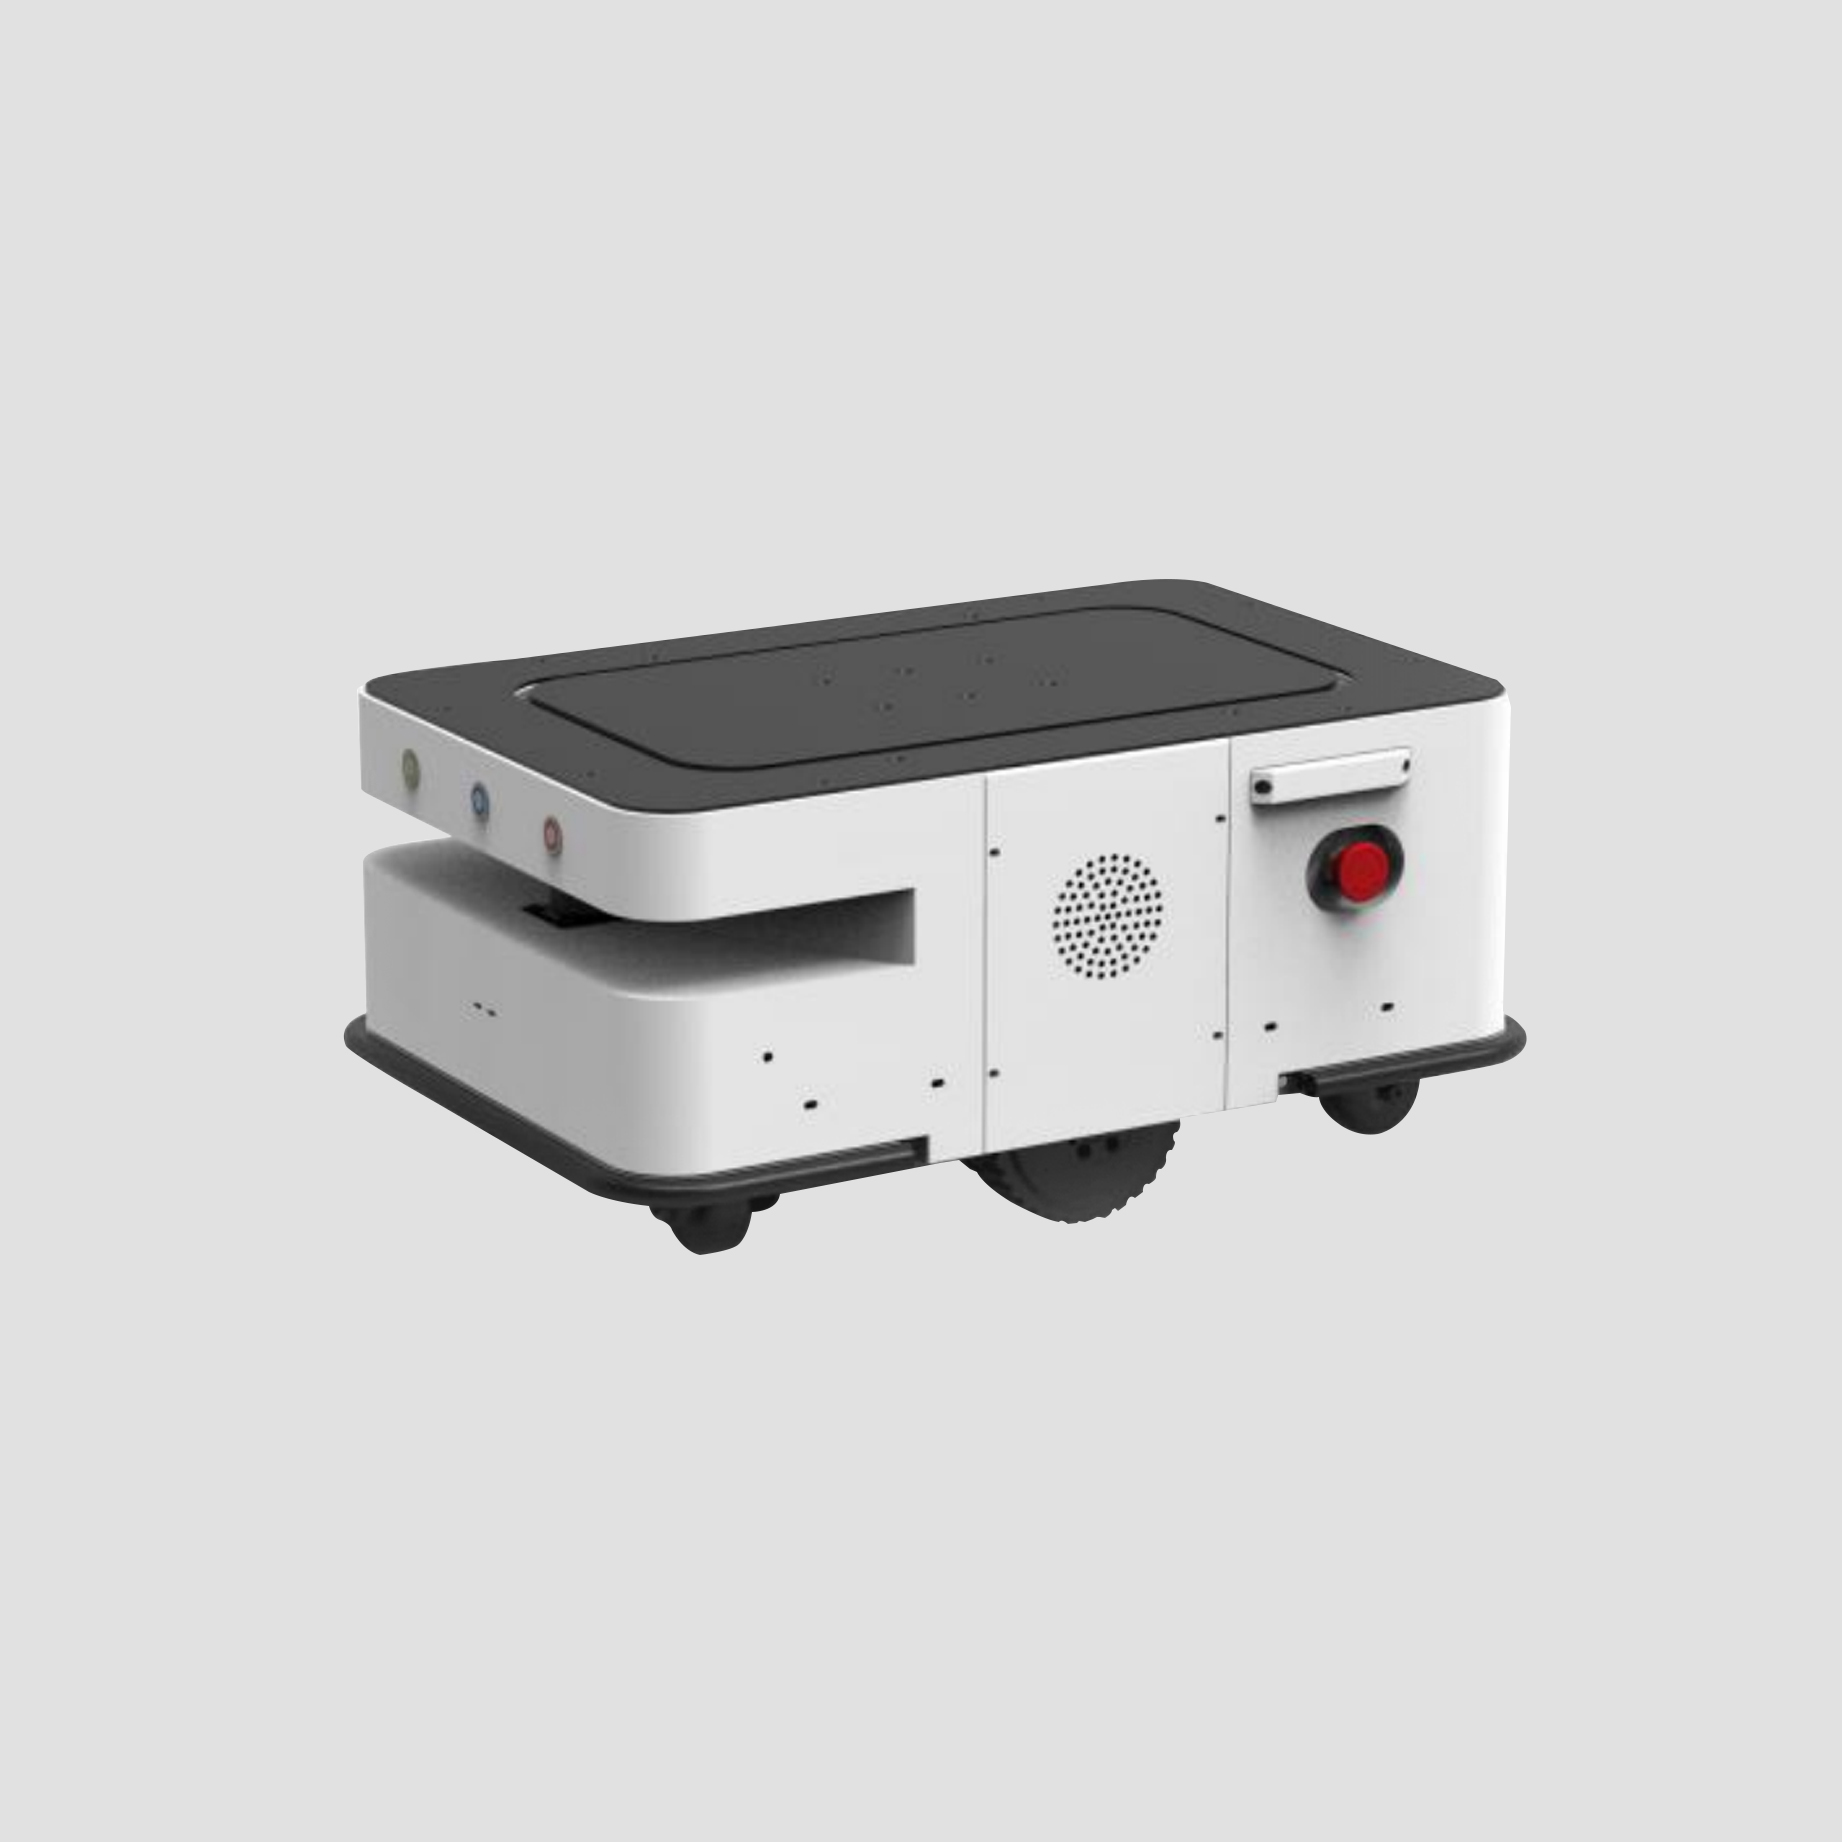
Я не буду расписывать общие фразы. Вот три конкретных метрики, на которые я опираюсь при выборе решения: 1) среднее время восстановления (MTTR) для AGV — цель ≤ 30 минут; 2) процент успешных маршрутов без ручной коррекции — цель ≥ 98%; 3) деградация батареи AGV по месяцу — цель ≤ 2% потери ёмкости. Проверяйте эти числа на пилоте (минимум 30 дней в режиме загрузки). В моём опыте пилоты с реальными пиками — в утреннюю смену и перед отгрузкой — дают реальное представление о надёжности. Я надеюсь, это поможет вам принять решение без пустых слов.
И в заключение: если вам нужна проверенная обратная связь или помощь с пилотом — я делал это лично более 18 лет и могу зайти с практической проверкой на площадке. (Да, иногда я беру с собой мультиметр и блокнот.) Для детальной консультации и оборудования рекомендую посмотреть решения от Wijay.
